在搞清楚Transformer的基本原理之后,我们再来讨论下,在Transformer之后,大模型领域有哪些变化和进展。本文作为一个初学者在学习过程中的记录,可能不一定能做到非常完整和系统。
Transformer之后大模型领域的变化和进展,总体来说可以分为下面这些方向:
- 架构演进
- 推理技术
- Scaling Law与预训练数据工程
- 后训练与对齐
- Agent、工具使用与外部知识
- 多模态与统一生成
- 可解释性、安全与评测
- 系统、工程与成本
在这个系列中,我主要会整理、学习和总结架构演进、推理技术这两个方向的内容,并在过程中涉及一些关于系统、工程与成本的内容。
本文首先讨论架构演进这一方向。
概览
自2017年Transformer提出以来,主干结构的实质改动其实有限。真正的变化几乎全部发生在架构之外:训练配方、后训练目标、推理时策略与工程系统。但其实模型结构内部各类优化改动还是有很多的。
下面我们讨论下模型结构的一些关键演进,而关于推理的内容将会在推理技术篇中总结,不过本篇仍或多或少涉及到一些推理的内容,毕竟推理性能也影响着模型设计本身。
演进方向
在注意力机制上搞事情:注意力效率与结构变体
在注意力机制上做的改进,核心思想都是:在尽可能不牺牲注意力效果的前提下,降低显存与访存开销。
早期探索(近似流派和稀疏流派)
近似流派(利用近似改写公式以降低计算量),例如:
- Performer(2020):【线性/核函数近似】利用随机特征映射将标准自注意力的Softmax核近似分解为两个低秩特征矩阵的乘积,将复杂度降低为线性
- Linformer(2020):【低秩近似】用低秩投影把K/V压到固定维度,将复杂度降低为线性
但是由于大多存在一些缺陷,例如投影无法支持自回归、无法动态处理变长的上下文,以及不适合工程实现和硬件并行化计算等,均已不再单独使用。
稀疏流派(剪枝以跳过影响较小的计算),例如:
- Sparse Transformer(2019):【稀疏注意力】采用分块和步长的网格状稀疏,Token只看自己同一块或固定间隔的Token
- Longformer(2020):【稀疏注意力】采用滑动窗口(局部只看邻居)+扩张滑动窗口+任务特定的全局Token 稀疏组合
- BigBird(2020):【稀疏注意力】继承了Longformer的局部和全局,并额外加入了随机采样,通过“局部+全局+随机”的稀疏图结构,在数学上逼近全连接的效果
但是稀疏流派不利于硬件计算,显存带宽利用率极低,甚至可能还没有不做任何数学公式改动的纯工程优化方案FlashAttention速度快。
不过,早期的近似流派和稀疏流派的思想仍可能会可能会以混合的方式出现在现代模型中。
MHA、MQA、GQA、CLA(共享KV流派)
核心目的是通过降低隐状态数量来降低KV Cache体积。
- MHA(Multi-Head Attention):传统多头注意力机制,每个头都有独立的Q、K、V
- MQA(Multi-Query Attention):让所有Q头共享唯一的一组K、V头
- GQA(Grouped-Query Attention):一种折中方案,将Q头分为多个组,一个组内的多个Q头共享相同的K、V头。若组数等于1,GQA就退化为MQA;若组数等于Q头数,GQA就等同于MHA
- CLA(Cross-Layer Attention):是一种在层之间共享KV的技术路线
传统MHA显存和带宽消耗大,MQA效果差,GQA在中小模型与稠密模型中最普遍,而CLA更适合端侧模型。
MLA低秩压缩(进阶版共享KV流派)
相比MQA/GQA,MLA(Multi-Head Latent Attention)不是粗暴地减少KV头数,而是对K和V进行联合低秩压缩。它在推理时缓存的不是完整的K和V,而是一个低维的隐向量,以及一个用于RoPE位置编码的共享向量(因为计算步骤中存在的RoPE矩阵乘法,会导致矩阵吸收失效,因此需要解耦RoPE)。
MLA本质上是把投影矩阵拆成了两个低秩矩阵的乘积,共用一个下投影矩阵
于是,KV会被
但其实它甚至不需要做恢复动作,在实际推理的decoding阶段,MLA采用了一种名为矩阵吸收的优化,将用于隐向量还原的高维升维矩阵提前融合到投影矩阵中,使得模型不需要把K和V显式还原放大。
对比一下原始Transformer就很明显了:
| 机制 | 注意力得分(Score)计算公式 | 推理时历史Token耗费的显存 |
|---|---|---|
| 原始 Transformer | 存储所有头的高维 |
|
| MLA (DeepSeek) | 仅存储所有头共享的低维 |
MLA能奏效的核心原因是,不同头的隐状态中的信息密度其实没有那么高,所以才能压缩。
但是如开头所说,RoPE位置信息要单独携带,无法融入其中。因此除了一个低维的隐向量以外,还需要一个用于RoPE位置编码的共享向量。
最后是一个在工程实现上的点:矩阵吸收本质上是改变了升维矩阵的结合方式(是否要与Q结合)。如果Q少,就可以吸收(与Q结合),牺牲计算换取更小的显存带宽消耗;如果Q多,就不需要吸收。因此矩阵吸收通常只在推理decode阶段做,而在prefill或者训练阶段不做。
可训练的稀疏注意力机制(现代稀疏流派)
Note
MLA解决了隐状态的压缩问题,稀疏注意力机制主要解决对哪些KV产生注意力的问题。
稀疏注意力这一方向核心要解决的问题有几个:
- 稀疏注意力gather操作与GQA等共享KV的访存模式冲突(最怕的就是每个头挑的token不一样导致KV没法共享),破坏内存合并访问,瓶颈从算力变成了不规则访存
- 往往只对prefill和decode的其中之一有加速,很难兼顾
- 稀疏注意力本质上要做离散选择,常见做法不可微,无法预训练
一种最简单的稀疏注意力机制,就是局部注意力,采用类似于滑动窗口注意力(Sliding Window Attention,SWA)的形式,简单粗暴。
随着研究深入,可训练的稀疏注意力机制被提出,典型方法如下:
- NSA(Native Sparse Attention,DeepSeek 2025-02):引入三分支门控,三个分支的输出用一个学出来的门控加权求和,模型自己决定每层每头更依赖哪条路
- 压缩分支:用可学习MLP聚合连续KV块,即把KV序列按连续块切开,每块用一个可学习的MLP压成一个代表性的K/V,Q对这些块摘要做全注意力
- 选择分支:只看摘要毕竟有损,所以再从所有块里挑top n个最相关的,对这些块内的原始token做精确注意力(top n的选择复用压缩分支算出来的注意力分数)
为了不与GQA产生冲突,NSA选择让同一个组内的多个Q头的打分做平均,从而合并为相同的决策。只有选择分支有这个问题,其他两个分支不会有冲突。
如果不这么做,极端情况下访存开销退化到与没有用NSA一样的情况,这是因为:每个头的矩阵计算是独立的,如果Q头对应的KV切片一样,就可以复用;如果不一样,就还要把所有需要的KV切片拉出来 - 滑窗分支:保留单独的近邻处理,防止局部模式吞掉长程学习
- MoBA(Mixture of Block Attention,Moonshot 2025-02):把MoE搬到注意力上,采用无参数门控(Q与块内K均值池化的点积)取top n个块。它没有增加可训练的参数,但是稀疏pattern本身是被训练出来的
- DSA(DeepSeek Sparse Attention,DeepSeek 2025-09):在注意力前加一个带参数的选路器(Lightning‑Indexer),先快速判断历史上哪些token值得关注,只把这部分送进真正的MLA注意力
由于DSA直接把索引也做成per-token、全head共享的,所有head共享一份top n列表,因此它可以与MLA直接集成
由于top n操作不可微,所以训练时会麻烦一些。NSA、MoBA采用上游打分链路回传的方式更新梯度,梯度经由被选中块内部的注意力计算回传。DSA需要分两步解决,先不开启稀疏,冻结主模型全部参数,单独训练选择器,再打开稀疏,但将选择器输入从计算图中detach,阻断模型损失向选择器回传。
但并不是每个方法都能与GQA/MLA同时使用的,所以在方案设计和选择上,与其他方法的冲突问题也是必须要考虑的。
从以上内容可以看出,各类方法其实已经在有机融合。
再额外提一下Attention-Sink现象:模型会天然把大量注意力权重分配给序列开头少数几个token,和语义无关,是softmax归一化带来的模型固有行为
针对Attention-Sink现象,有一些不同的做法:有些模型会将这个现象显式化,也有一些模型会反向消除它
StreamingLLM就是利用Attention-Sink现象,推理时强制永久保留前N个sink token并结合滑动窗口策略,是一种固定模式稀疏注意力机制
原生可训练稀疏已成为长上下文主流路径之一,且明显趋势是稀疏性向训练早期迁移(训练时就开启稀疏)。
线性注意力与状态空间模型(现代线性流派)
核心问题:能否用线性复杂度、固定大小状态的机制替代全注意力。
- 线性注意力:通过一个映射函数
,把 近似拆解为 ,然后利用结合律先计算 ,使得中间状态的大小只与维度有关而与序列长度 无关,计算复杂度直接降为 它与RNN的核心区别是,RNN是把全部历史压缩成一个向量,而线性注意力本质是快速权重,存储K到V的映射矩阵,用于与Q相乘得到结果
线性注意力在训练阶段能够并行的核心原因是它的递归转移满足结合律,因此可以直接分块并行,而RNN不行 - 状态空间模型(SSM):类似RNN,把文本序列压缩进一个能够随时间不断更新的隐状态中,但它不在隐状态的传递上引入非线性激活函数,而是在外部引入非线性,从而在支持并行计算的情况下提升表达能力(训练时并行,推理时像RNN一样串行),属于一种特殊的RNN
SSM的隐状态迭代本质上就是线性层的叠加。
对于静态SSM(每个线性层参数固定),该计算就是卷积,可以直接并行。
对于动态SSM(每个线性层随着输入动态变化,称为选择性机制),可以通过并行扫描(前缀和)来并行。
线性注意力与状态空间模型存在很深的数学联系。在部分结构化子类(1-半可分)下,二者是从不同的视角(注意力视角、循环视角)去描述同一个计算逻辑(通用情形下二者表达空间重叠但并不严格等价),并在现代架构中走向了深度融合。
接下来分别介绍两个方向的典型模型,并不完全是最新的,后面还有一些衍生版本,但核心思想一致。
状态空间模型Mamba:属于动态选择性SSM,SSM参数由输入动态生成,自主控制历史信息的留存与丢弃;训练借助并行扫描实现序列并行,推理以固定大小隐状态迭代,无膨胀KV Cache,为线性复杂度,再通过硬件定制kernel增强性能;整体是用状态更新机制替代Transformer自注意力
线性注意力Gated DeltaNet:区别于普通线性注意力的简单累加KV信息,它引入动态门控+增量Delta更新机制,模型会先通过输入自适应门控衰减、遗忘冗余的历史记忆,再仅用新token的残差信息修正、更新固定尺寸的记忆状态,而非无脑叠加新信息
混合注意力机制
很显然,GQA和MLA这种由于作用对象不同(一个是降低KV隐状态大小,一个是降低参与注意力计算的历史KV数量),其实是可以融合使用的。
事实上,线性注意力与全注意力也是可以混合使用的。例如新发布的Qwen3.8-Flash-Next就同时使用了线性注意力GDN(Gated DeltaNet)层与稀疏注意力QSA(Qwen Sparse Attention)层按3:1的比例交替堆叠,且稀疏注意力使用了MQA索引器结构。
混合注意力已成为新常态。
混合架构核心需要考虑几个问题:线性注意力与全注意力的配比与排布、稀疏还是全局、位置编码归谁、是否叠加MoE等。
在FFN网络上搞事情:提高知识存储容量和深层网络训练稳定性
FFN扩张比
在Transformer架构中,每个注意力层后面都紧跟着一个FFN层。FFN扩张比代表了FFN隐藏层(中间层)的维度与模型主隐层(输入/输出)维度之间的比例关系。
intermediate_size与hidden_size之比就是FFN扩张比。
由于激活函数(特别是ReLU)会造成近50%的稀疏化或信息损失,因此FFN扩张比通常设置为4,以确保高维特征的非线性表达能力。而在SwiGLU下,由于三个矩阵的存在,为了使总参数量与传统4倍扩张的两矩阵FFN保持一致,通常将扩张比下调为
MoE(混合专家)稀疏大模型架构
其核心要解决的问题是:如何让模型容纳更多知识而不等比例增加推理成本。
具体做法是把每层FFN换成多个专家FFN,由router决策每个token激活其中的哪些,且只激活其中少数几个。
MoE的本质就是将FFN层的总扩张比做到了几十倍甚至上百倍(拥有海量的隐藏神经元作为参数容器),但通过稀疏路由机制,让每个token在前向传播时只激活其中的一小部分专家,这在隐式上完成了类似于超高维投影的效果。
以DeepSeek-V3为例,671B总参数、每层256个专家、激活9个(1共享+8路由),激活参数仅37B,却比稠密的405BLlama 3更强且推理更省。其中共享专家是指始终保持激活状态、不参与动态路由选择、负责捕获和整合全局通用知识的固定专家模块。
一个现象是稀疏度在持续走高:
| 模型方案 | 总参数量 (Total) | 激活参数量 (Active) | 激活比例 | 专家设计特点 |
|---|---|---|---|---|
| Mixtral 8x7B (2023底) | 47B | 13B | ~27.6% | 8个粗粒度专家的top 2 |
| DeepSeek-V3 (2024年底) | 671B | 37B | ~5.5% | 256个细粒度专家的top 8 + 1个共享专家 |
| Llama 4 Maverick (2025年4月) | 400B | 17B | ~4.25% | 128个细粒度专家的top 1 + 1个共享专家 |
| GLM-5.2 (2026年中) | ~744B | 40B | ~5.3% | 256个细粒度专家的top 8 + 1个共享专家 |
| DeepSeek V4-Pro (2026年中) | 1.6T | 49B | ~3.0% | 384个细粒度专家的top 6 + 1个共享专家 |
MoE架构有一个很关键的问题:少数大型专家还是众多小型专家?近期的趋势和发展表明,使用更多、更小的专家是更有效的。
MoE也有几个固有难题:
- 路由与负载均衡(常见解法是辅助损失、无辅助损失均衡策略)
- 专家并行(Expert Parallelism, EP)带来的All-to-All通信开销
- 硬件资源的错配(显存要按总参数算但算力要按激活参数算)
激活函数的演进
早期我们想要在FFN上实现非线性使用的是ReLU。当前,SwiGLU已成为事实上的标准激活函数配置。
SwiGLU采用双支路并行设计:输入分别经过两组独立线性投影,一条支路输出变换后的特征,另一条支路经过Swish/SiLU得到动态门控系数,两路结果逐元素相乘融合。这相当于FFN内部一个可学习的门控开关,使模型自适应筛选重要语义、抑制冗余特征。从实际表现上看:相比ReLU,它缓解了神经元永久死亡与梯度不稳定问题;对比GELU,显式乘法门控带来更强的非线性表达能力。
在位置编码上搞事情:位置编码与长上下文扩展
要解决的核心问题是:位置信息如何注入才能泛化到训练时未见过的长度;以及窗口做大之后,模型是否真的能用好其中的信息。
从绝对位置编码到旋转位置编码
Transformer原文使用的是三角函数绝对位置编码,当前旋转位置编码RoPE已逐渐成为事实标准。
RoPE利用绝对位置构造旋转,表达相对位置关系:它通过将词元向量在二维子空间中进行旋转,在计算注意力点积时自动暴露出两个词之间的相对距离。
RoPE有几个十分优雅且重要的特性:
- 支持长文本:RoPE理论上支持无限长度
- 极致的计算效率:RoPE属于零参数机制,不增加训练负担;同时它的数学形式可以完美借助FlashAttention等现代GPU算子进行硬件级加速,几乎没有推理性能惩罚
再来详细分析一下RoPE为什么低成本做上下文扩展:
RoPE的rope_theta在推理时可以根据需要修改。RoPE的数学推导证明了,Q和K乘以旋转矩阵后,进行点积运算时,绝对位置被消去了,只留下了相对位置差。不是像三角函数位置编码是一个绝对位置的概念。调大rope_theta相当于把整个特征空间里的相对距离等比例缩小。对注意力机制来说,它看到的只是注意力权重矩阵的波形变得稍微平缓了一点,依然能识别出谁和谁应该产生注意力,模型已经学会了理解这种pattern。
不过这种操作也不是没有代价的:虽然调大后会减缓长距离注意力衰减,但是会牺牲短文本的局部精确度。
这种操作虽然可用,但如果是想要保障长文本的效果,通常必须配合一定量的长文本数据进行继续预训练或微调。
混合位置编码与NoPE
NoPE的核心洞察是:因果掩码本身就携带顺序信息(第t个token只能看到前t个token信息),这个可见计数就是位置,因此理论上NoPE可表达绝对与相对位置编码。
当然,理论是理论,实践是实践。NoPE与逐层差异化是近期的趋势。
实际落地的混合做法有四种形态:
- 不同层不同base(
rope_theta) - RoPE与NoPE按层交错
- 把位置职责整体外包,注意力放弃位置建模,交给注意力以外的模型结构处理
- 部分RoPE,让部分维度不旋转
朴素的想法是:编码位置所需的维度远少于编码语义,留一批无位置信息的通道是有价值的 例如MLA中,由于RoPE无法压缩,因此拆出小维度做RoPE,剩下保持无位置便于应用MLA
在嵌入层上搞事情:嵌入层优化也能无痛提升模型性能
权重绑定与词表一致性
对权重来说:早期模型和一些小模型对输入embedding和输出lm_head共享权重,属于是省参数手段。还有完全解耦、部分token解耦、维度解耦(输入输出维度不一样)等方案。
对词表来说:也是可以解耦的,Over-Tokenized Transformer(字节Seed, ICML 2025)打破了传统Transformer通常共享或绑定输入输出词表的做法,实现了两者的彻底解耦。
词表扩展:N-gram嵌入技术
词表扩展也是一个可以做的重要方向。Scaling Laws with Vocabulary给出了首个把词表规模纳入scaling law的框架,在输入输出词表绑定的前提下词表大小存在最优值。Over-Tokenized Transformer除了推翻了输入输出词表必须绑定,另一个贡献就是通过大规模扩展词汇表来无痛提升LLM的性能打破了必须堆叠模型层数或参数量才能变强的固有认知,嵌入参数成为一个新的独立缩放维度(其他的主要是参数、数据等)。
N-gram是一个重要的词表扩展方法,它属于典型的老思路新应用。用WXC的话说就是堪比订书机订外卖袋子。
朴素的N-gram是指N元语法的意思,也就是N个token的组合,两个token的组合就是2-gram。在LLM的嵌入层中引入N-gram,其实是指将token级N-gram查表,作为嵌入层的扩容轴。简单来说就是从原先的每个token一个嵌入向量,变成了给一些token的组合也分配一个嵌入向量,作为嵌入层的补充。
其核心动机是:Transformer里有大量静态知识——固定短语、命名实体、成语、代码模板等。比如要理解一些组合词汇,模型得靠好几层注意力+FFN一层层拼出来,本质是用昂贵的动态计算去模拟一次廉价的查表。那不如直接给这个N-gram一个专属向量,一步就能查出来。
N-gram词表扩展的本质是一条新的稀疏扩容轴:加的参数全在稀疏查表里,几乎不增加计算量,还能把词表卸载到内存甚至SSD。
介绍几个代表工作:
- SCONE(固定集合式N-gram词表):只覆盖高频集合,长尾走默认路径;需要预扫描语料库统计频次
- Engram(哈希式N-gram词表):任何N-gram都有对应的嵌入向量,但会有碰撞,靠多头+门控缓解;不需要预扫描语料库
在实际模型设计中,需要找到合适的位置和方法将N-gram嵌入信息加到模型计算中。
tokenize新架构
在tokenize方面,除了BPE,还有一些探索,例如tokenizer-free架构的BLT。当前应用不太多,这里不做详细展开。
在整体架构上搞事情:后Transformer架构
从上文可以看出,Transformer架构已经产生了相当多的变体。本节再讨论一些在上面没有讨论的相对零散的一些话题。
解码结构:多Token预测(MTP)
传统LLM选择的训练目标是Next-Token Prediction(NTP),即在位置t上预测下一个t+1位置上的token。
Multi-Token Prediction(MTP)的核心思想是:不是只预测下一个token,而是同时预测多个未来的token。
MTP并没有脱离自回归的基本范式,模型在主干网络上依然是逐个时间步向前推进的,它是在每一个自回归步骤中,模型除了预测紧邻的下一个token外,还通过附加的预测头(MTP Heads)同时多预测几个接下来的未来token。
在推理阶段,这些多预测出来的token通常配合投机解码使用:一次性并行生成多个候选token,然后通过主模型并行验证,从而实现数倍的推理加速。可以把MTP理解成不需要一个单独小模型的投机解码数据源。
除了使用在投机解码中,对准确率要求不是特别高而对延迟要求极高的场景,也可以使用MTP。
连接结构
残差连接结构也出现了一些优化版本。
- 残差连接(Residual Connection):使用恒等映射思想,原样直接把输入加回来,确保信号在深层网络中稳定传播。但是结合LayerNorm之后,存在Pre-Norm/Post-Norm的固有矛盾(梯度消失/表征坍缩)。
- 门控残差连接(Gated Residual Connection):在标准残差连接基础上引入可学习的门控机制
- 超连接(HC,Hyper-Connections):(字节Seed,ICLR'25)将单条连接改为多条连接,用可学习矩阵,让各条流之间互相混合、交换信息。网络可以自己学习跨层信息流动模式,可以一部分流走Pre‑Norm行为,一部分流走Post‑Norm,甚至根据不同token,动态调整信息流的混合方式。当混合矩阵等于单位矩阵,HC直接退化成标准残差连接。但是由于混合矩阵完全自由可学习,当网络深度很大时,矩阵连续相乘,数值会指数爆炸或指数衰减,训练极不稳定。
- 流形约束超连接(mHC,Manifold‑Constrained Hyper‑Connections):把混合矩阵强制约束为双随机矩阵,矩阵每行、每列求和等于1,数值非负。这使得输出只是输入流的加权平均,保持信号总能量的稳定。简单来说就是通过数学流形约束,保证多层累积之后信号依然稳定,解决HC的训练爆炸问题。
微观结构与训练稳定性
除了模型拓扑、参数量等,模型的微观结构同样重要,往往对模型收敛效果的影响很大。例如:
- LayerNorm->RMSNorm:RMSNorm便宜、冗余成本低,已成标配
- 归一化的位置:Pre-LN还是Post-LN或其他变体,以及它们的位置
- QK-Norm:对Q/K也做Norm
还有参数量配比问题:不同类型的网络节点(例如注意力与FFN)的参数配比、混合架构的不同方法的参数配比。
以及在训练过程中,应对loss spike(loss突刺)的正则化方法、辅助损失函数、Logit Soft-Capping、优化器优化等等。
前沿探索:自适应计算深度
自适应计算深度这个方向基于这样一个朴素的想法:不是每个token都值得花同样的计算量。
因此,我们可以想办法尝试为部分token跳过模型的一些结构,以降低计算量。
MoD(Mixture‑of‑Depths)是其中最经典原生自适应深度架构。核心思路是每一层加一个路由器,对每个token做决策:要不要执行本层的计算,不执行就直接走残差连接跳过整层。但是它对于工程实现和硬件都不是很友好。
目前该方向仍处研究阶段,截至目前无公开前沿模型采用token级动态深度。
前沿探索:训练与推理的权重边界
这里探索的核心问题是:参数本身在推理时是否还在变,称为测试时回归(Test-time Regression)。例如Google的Titans。其实上面提到的SSM也是一种测试时回归,因为选择性状态空间模型在隐状态上的每一次步进,本质上就是在执行带有特定选择性权重的测试时回归。同样地,目前还没有广泛应用。
推理时计算(Test-time Compute)是一种折中路线,典型的就是DeepSeek-R1,将复杂度放在CoT上,通过消耗更多推理算力去搜索、反思和纠错。
一个实际例子
以LLM Architecture Gallery上最新的GLM-5.3-Flash模型为例:
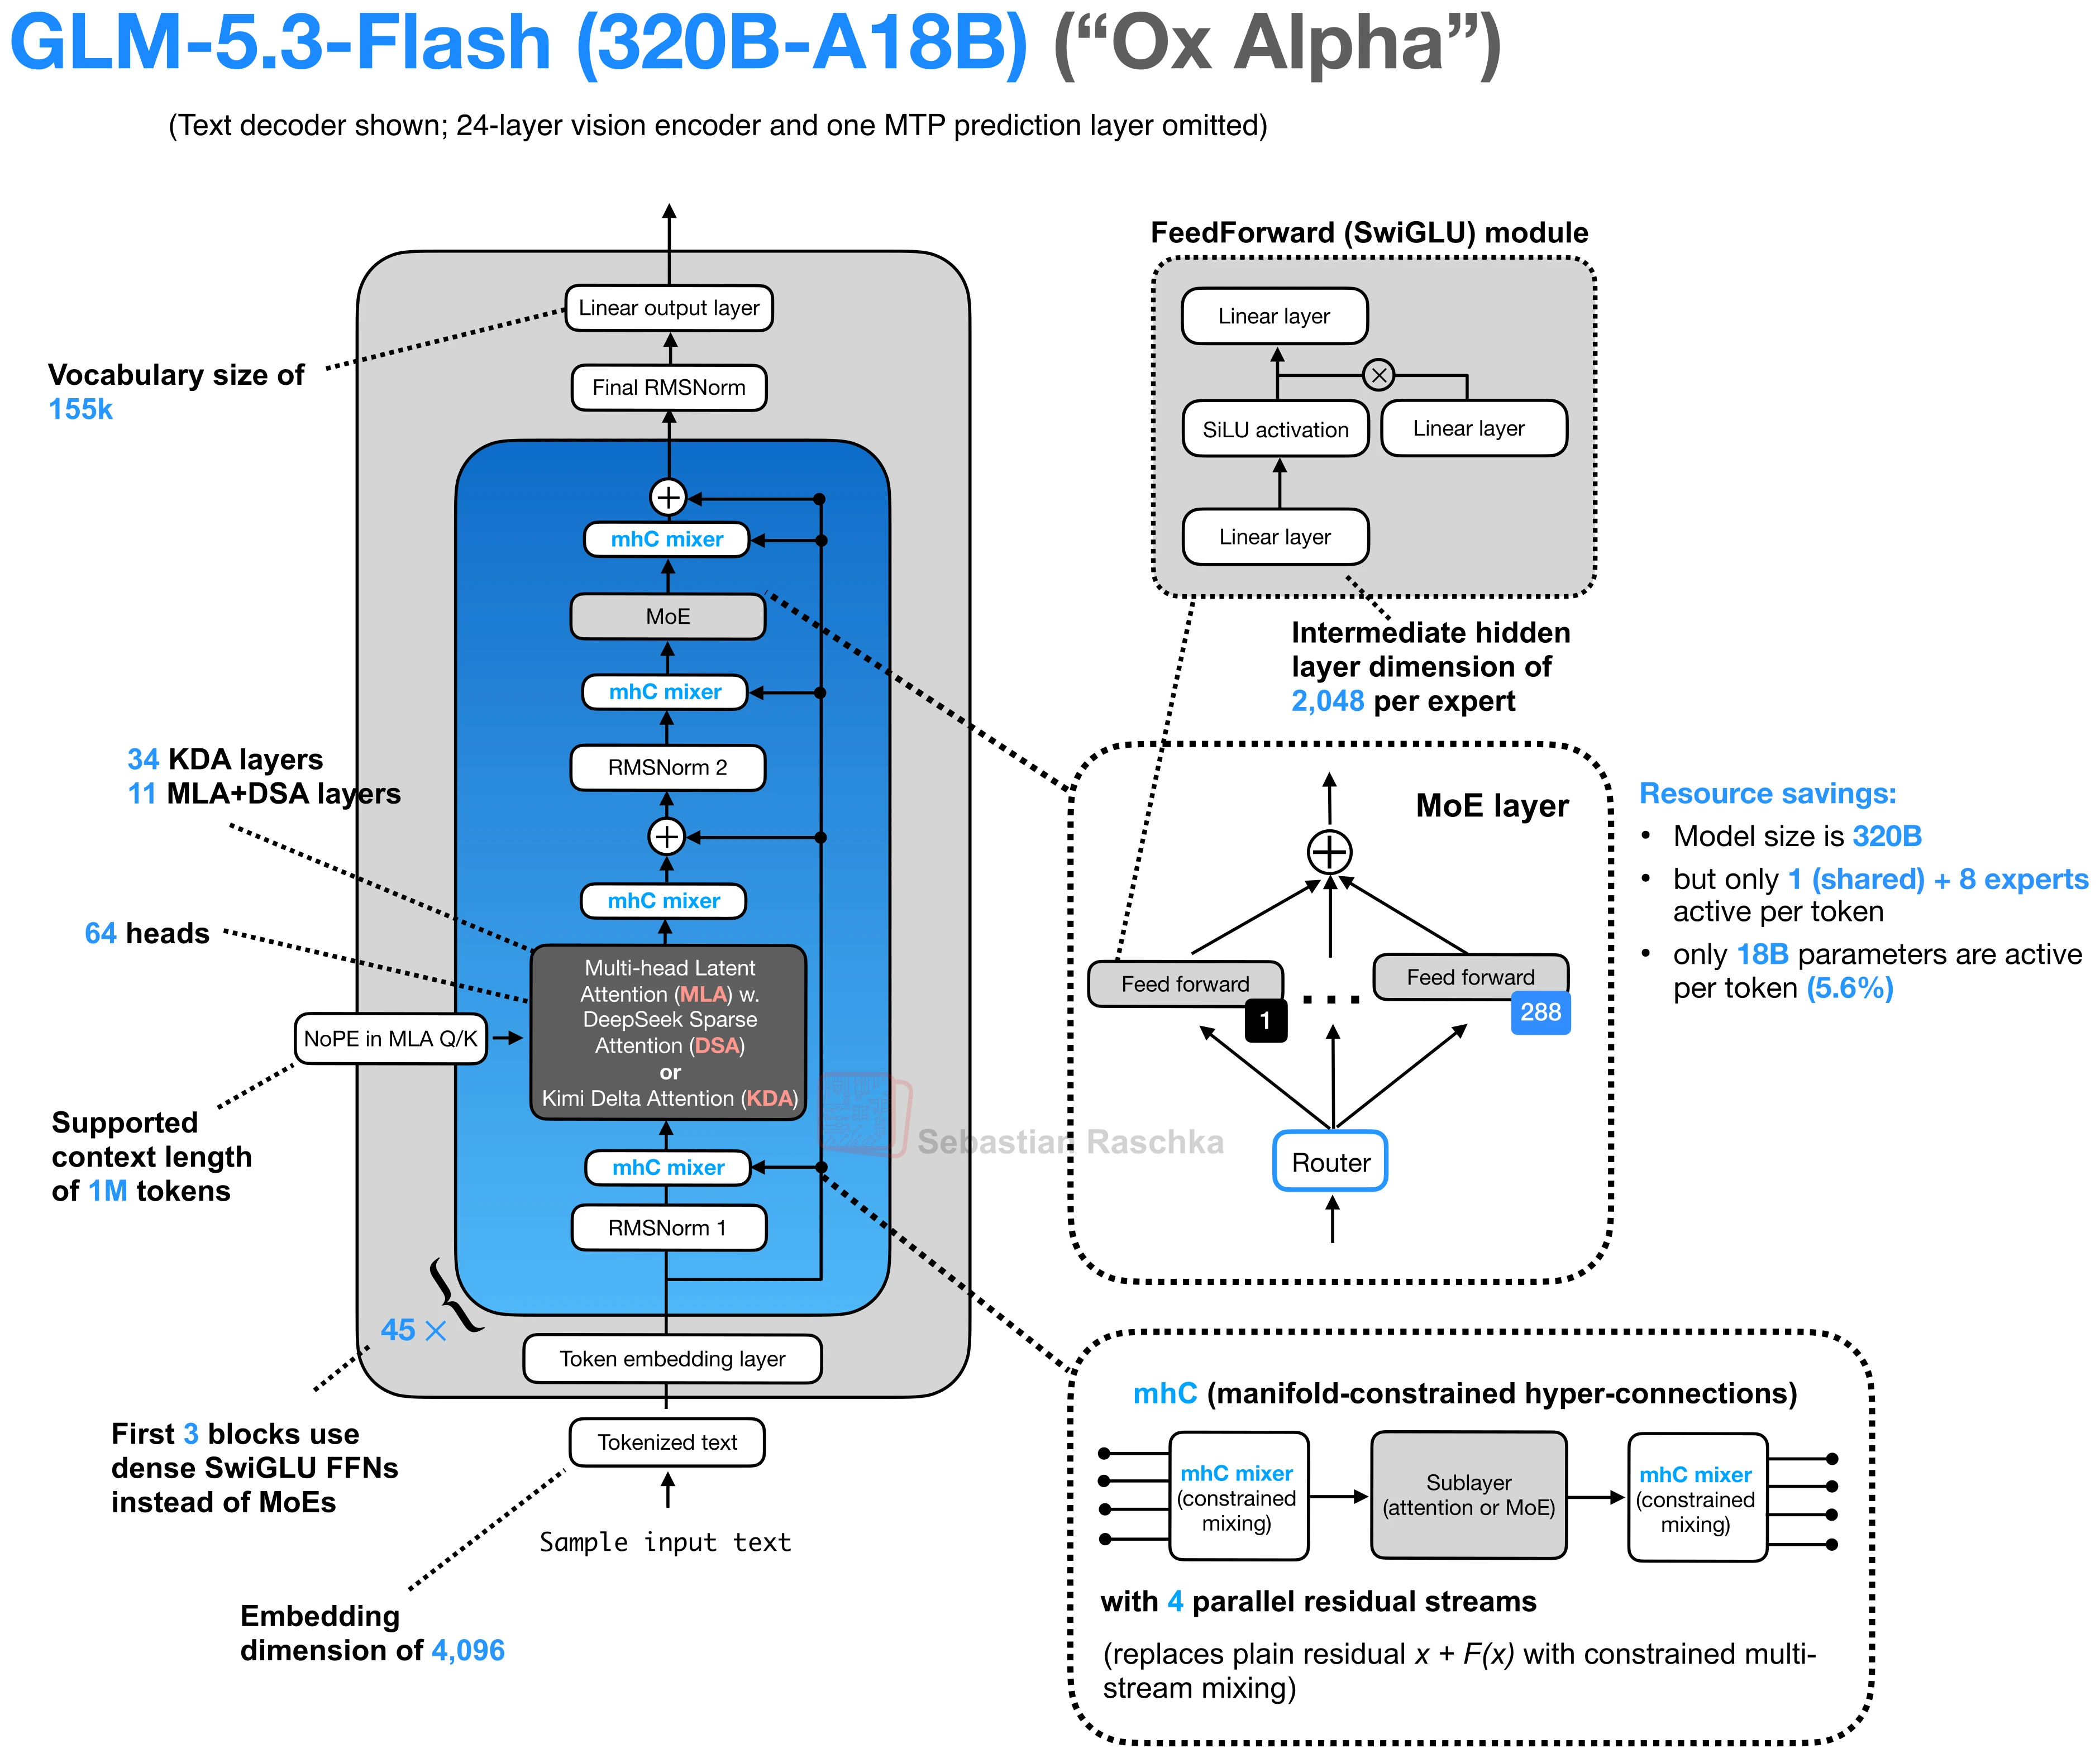
它使用了我们上面所提到的:
- 注意力机制:使用MLA+DSA与KDA(Kimi Delta Attention,属于线性注意力的一种)交替,并采用NoPE(移除了显式的位置编码)
- 残差连接:使用mHC
- FFN:使用MoE架构,并采用SwiGLU激活
- 嵌入层:输入与输出嵌入层分离
以及之前所说的一些概念,与参数的对照大致为:n_kv_heads与num_attention_heads的比值就是GQA分组、rope_theta就是位置编码base、num_experts与num_experts_per_tok就是MoE配置、intermediate_size与hidden_size之比就是FFN扩张比。
关于更多的模型比较,可以看下Sebastian Raschka(从零构建大模型的作者)的The Big LLM Architecture Comparison,介绍了从DeepSeek V3到GLM-5的现代LLM架构设计和其中所使用到的技术。
欢迎留言